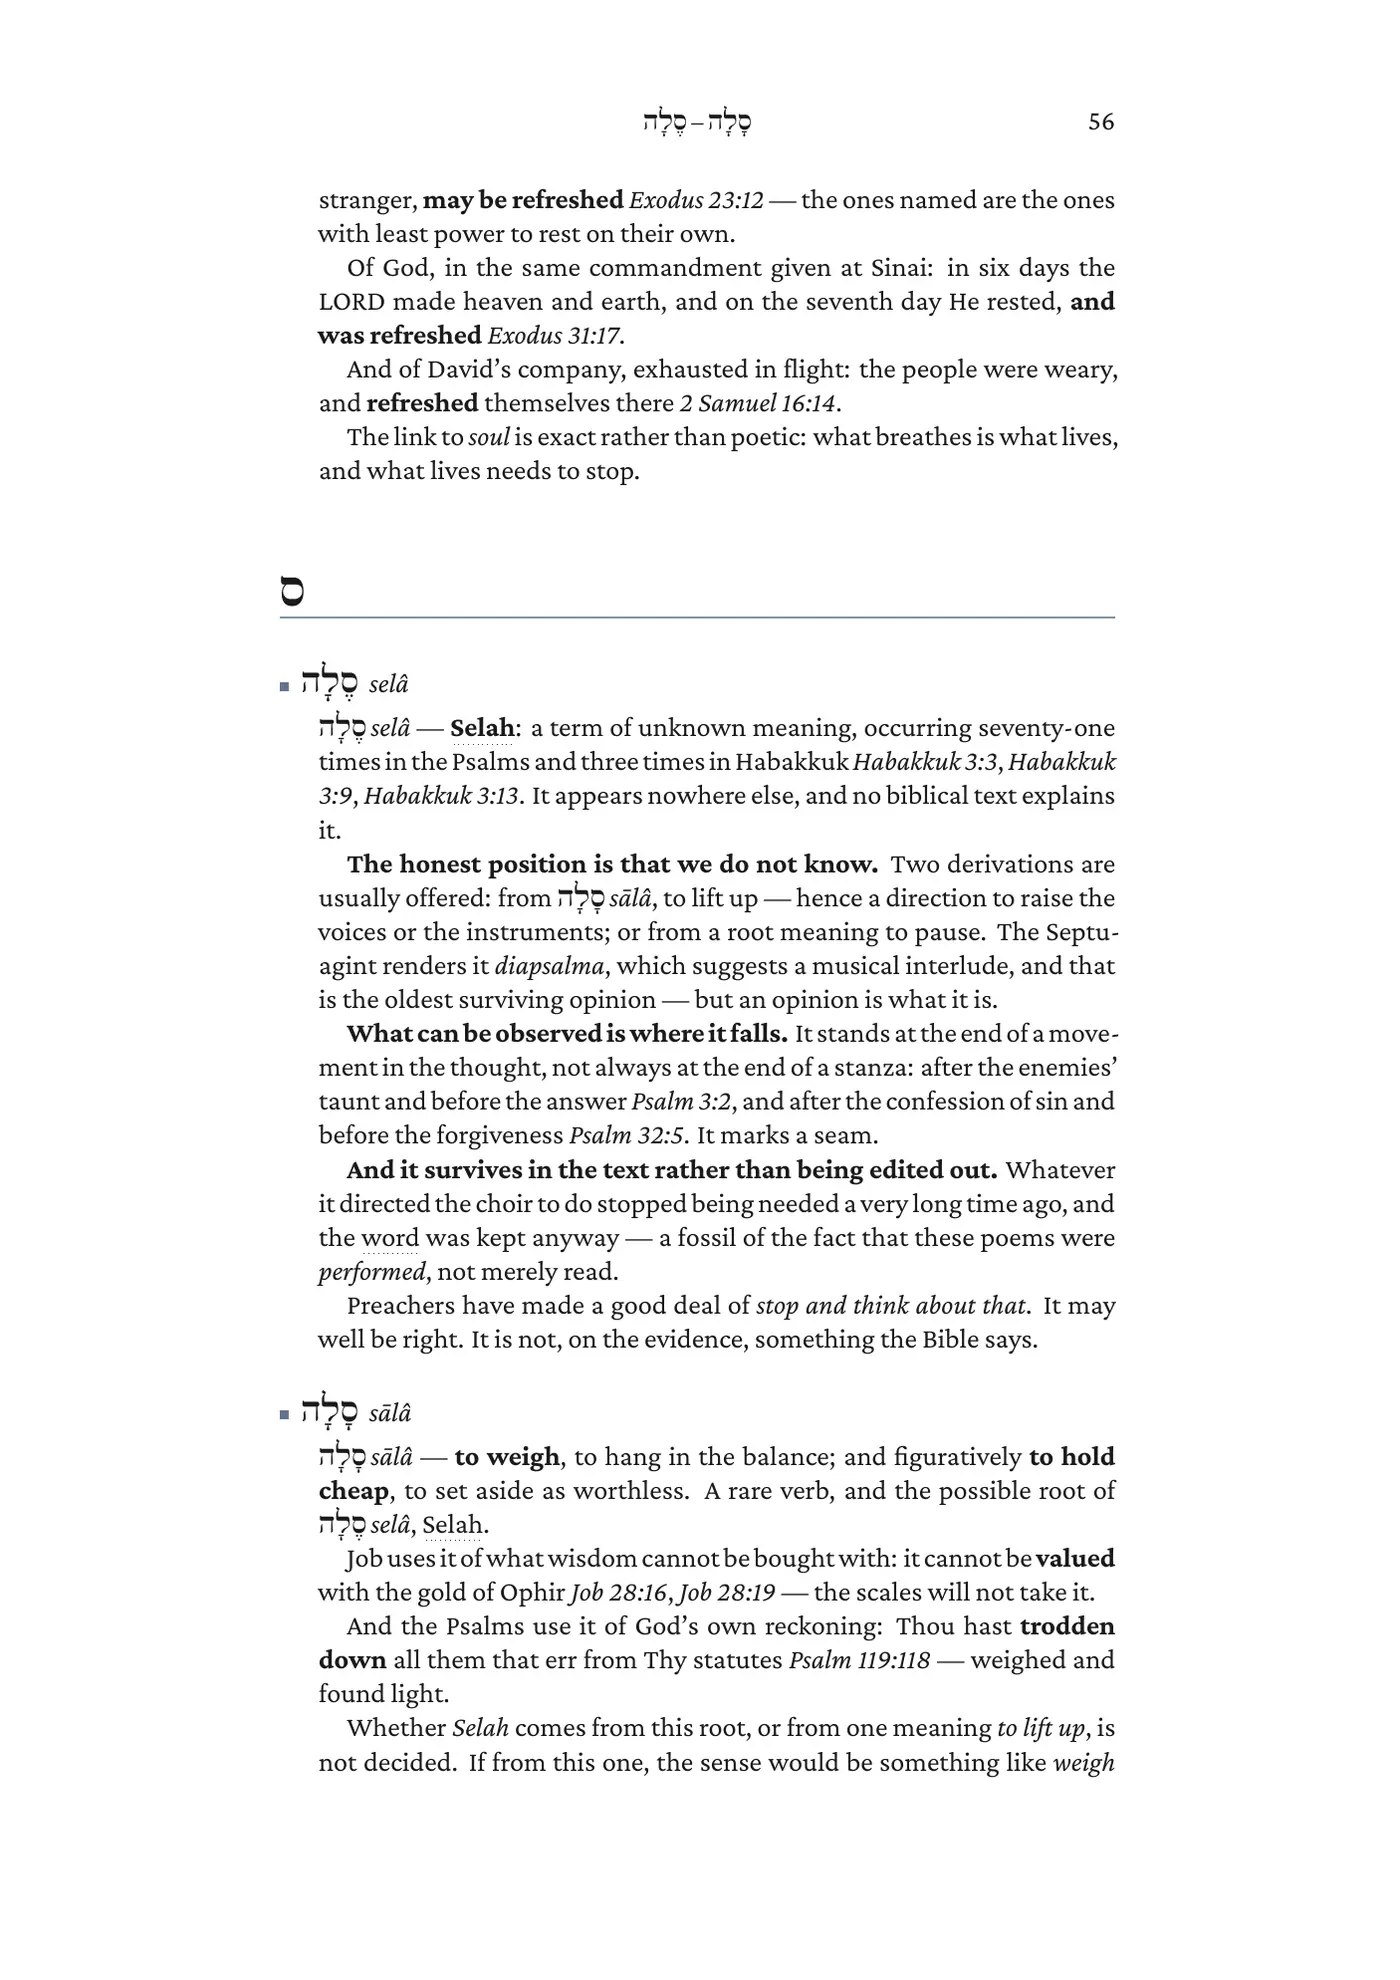
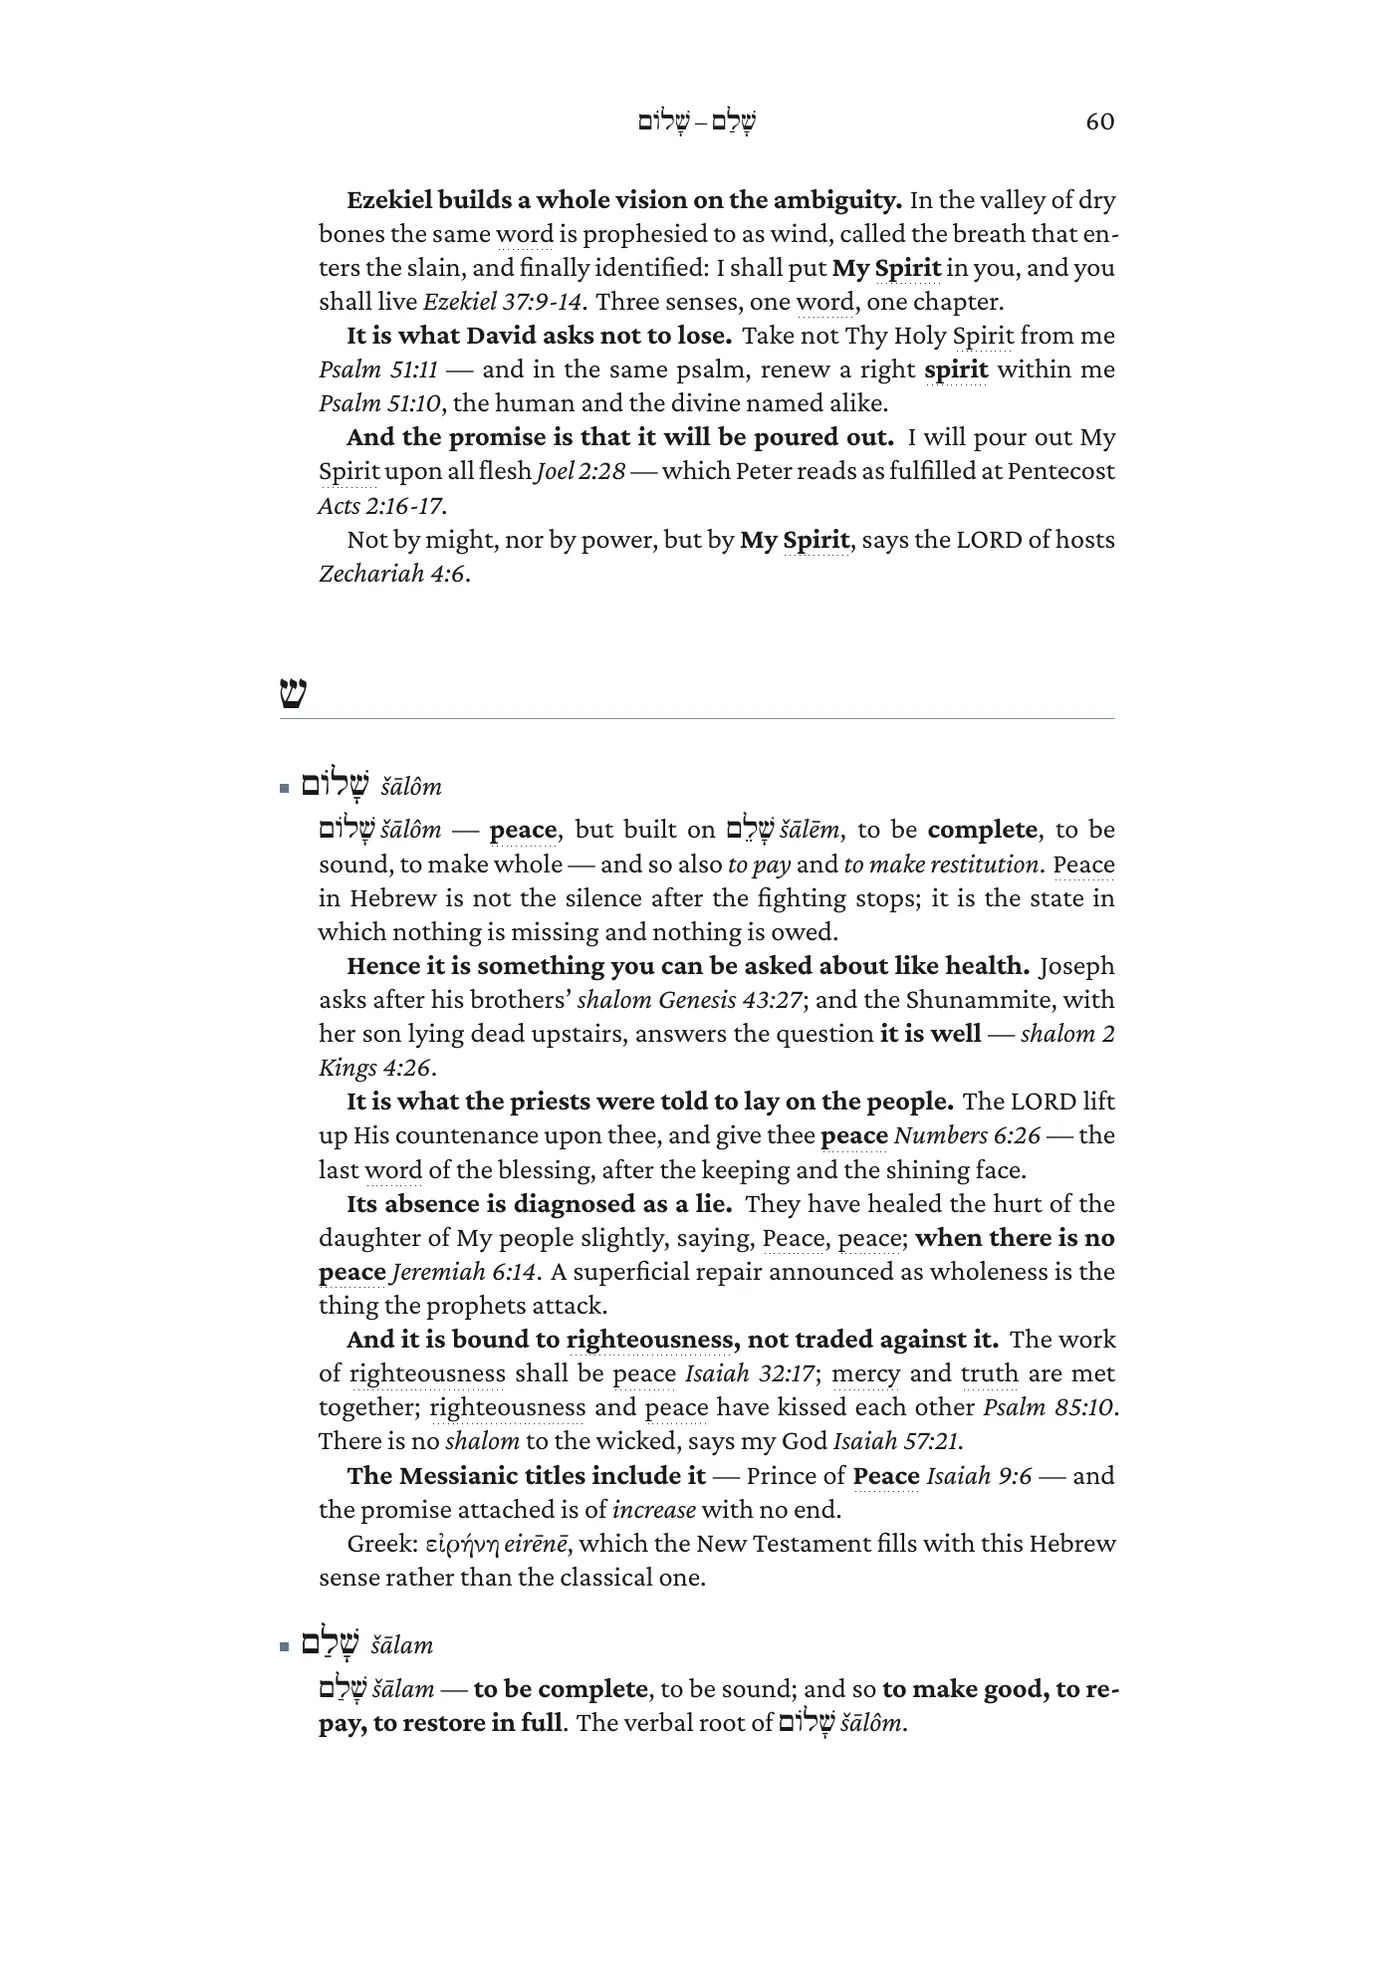
多数查经软件到笔记为止。而笔记往往正是工作夭折的地方——只有你读得到,只在一台机器上,格式别人打不开。Lexifye 从第一次敲键盘起就把词条当作可出版的内容对待:结构化的义项、带类型的片段、真正的文字系统。所以从“我的笔记”到“一本有书脊的书”,只是一次渲染,而不是重写一遍。
这里的一部词典完全可以独立成立——你根本不必写书,也能得着它的好处。但如果你写,它就会成为更多的东西。
Lexifye 是你建立自己词典的地方:那些在经文里一再遇见的词、你在其中的发现,以及它为什么重要。今天查过的词,五年后依然在那里——连同你这些年陆续添加的一切。当它准备好离开你的书桌时,同样这些词条就能变成一本印刷书、一个 EPUB,或者一个私人阅读器,分享给一个查经小组,甚至整间教会。
这里头有一种真实的乐趣,却没人事先提醒你。自己写的词典不是需要维护的杂务——它是书桌上最让人享受的东西,因为每一条词条都是一次可以留住的小小胜利。十个词变成三十个;这三十个开始彼此对话;某天早上你会发现,你正带着一样任何研读本圣经都给不了你的东西在读经,因为那是你亲手建起来的。
从 Claude、DeepSeek 或你自己的智能体登录一次,它就能代表你把词条写进你的词典——署你的名字,并且可以在同一个页面上撤销。
在用人工智能做开发?工具接口 就是那份手册,专为机器阅读而写: 94 个工具,每个都带访问级别和完整模式,另有写作规范和标记语法。要使用网页编辑器,这些一样都不需要。
本页导航
为什么要有一部
适合谁
它能产出什么
任何主题
Darash 与 Junifye
一个词,从头到尾
谁能看到
内部构造
常见问题
如何开始
为什么要建立或加入一部词典
因为查阅并不等于研读。任何人都能查到hesed 是“坚定的慈爱”——明年再查一次,后年再查一次,却什么也没有留下。真正的研读,是你第四次遇见这个词时、在一处没人告诉你要与之相连的经文里所注意到的东西。
属于你自己的辞典,正是这些积累下来的地方。每一条词条都装着你的义项、你的措辞,以及说服了你的那些引证。你所引用的希伯来文和希腊文本身也会成为真正的词条——原文字体、转写、由我们的经文引擎汇成的词义——于是三月里你只是半懂的词,到十月就成了你能拿来教导的词。
你不必懂希腊文或希伯来文才能开始,也不必是程序员才能使用它:它是一个登录即用的网页编辑器,而原文那部分工作,在你引用一个词时就已经替你做好了。
牧师
主日每周都来,同样那些词也跟着来。把词条建好一次——你所定下的义项、决定它的那些经文、你否决掉的读法和理由——此后每一篇讲道都从上一篇结束的地方开始,而不是从一张白纸开始。
传福音的人
问题总是重复:那个词到底是什么意思、它还出现在哪里、为什么各译本不一样。把答案放在你在压力下也找得到的地方,再把最常给出的那些印成一本随手可留下的小书。
宣教士
在语言之间工作,无论你怎么称呼,本质上就是词典工作。十六种文字系统都能正确排版——希伯来文、希腊文、阿拉伯文、天城文、埃塞俄比亚文等等——因此你为外派团队所建的词汇表是可以出版的,而不是一堆只在你自己机器上才渲染得出来的笔记。
平信徒
你读圣经,想比脚注走得更深。就从十个一再拦住你的词开始。一年之后,你会拥有一样任何研读本圣经都给不了你的东西,因为那是你自己读经的记录。
学生
一门课反复用到的那些词——希腊文课上的、神学院论文里的、你正在学的一门语言里的——在你第一次遇见时就用自己的话定义下来。写下词条正是让它记牢的办法;等到明年的课程再问起同一个词,它依然在那里。
研究生
一篇学位论文,就是同样那四十个词在不同文献里含义略有出入地纠缠三年。把每一个都一次定下来,附上你的出处和你的推理,等你写到依赖它的那一章时,它还在那里。你的导师也可以和你一同在里面。
教师或小组带领者
把阅读器给你的班级,他们就能在手机上读你写的内容,什么都不用登录。把一位同事以受邀编辑的身份请进那一部词典,别的都不开放。学期一结束就收回权限——成员身份在每一次请求时校验,因此撤销是即时生效的。
研究团队或委员会
若干个人,一套受控词汇,一条审计轨迹。群组挂上一次,所有人就都在里面了;术语不再散落在六份各自的私人脚注里,而是集中到一个大家共同写入的地方。
译者或学者
是结构化的义项,而不是一团散文;有精确的版本历史,可查看差异、可回退;每部词典还有一条审计轨迹。这份工作经得起协作者更替、经得起反复推敲,也经得起岁月。
Lexifye 完全不知道你的词是关于什么的。一部词典无非是一份术语清单、你赋予它们的义项,以及你信任的来源——而具备这个形状的,远不止希伯来文和希腊文。它既是教会的工具,也同样是学校、院系或教研室的工具 ,两边的形状完全一致:一个人把它建起来,几个人参与其中,其余所有人拿到的是完成品。
一份供课堂使用的挪威语—英语词汇表 就是一部词典:本周的生词、十岁孩子真用得上的释义、一个例句;它能打印成讲义,也能在手机上阅读。把它和 Junifye 里下周的课文配在一起,这篇课文的词汇表就会自己生成——四年级的学生拿到的是课文,以及课文里真正用到的那些词,而不是一份通用词表。
十六种文字系统各用自己的字体排版——希腊文、希伯来文、阿拉伯文、波斯文、西里尔文、中日韩文、天城文、孟加拉文、泰米尔文、泰卢固文、卡纳达文、古木基文、埃塞俄比亚文、亚美尼亚文、泰文以及扩展拉丁文——其中三种是从右往左书写的;每次渲染前都有检查,宁可拒绝出版一页空方块,也绝不把它们印出来。对于语言、古典学或语言学院系来说,这通常就是全部问题所在。
圣经相关的机制是可选的,而且可以完全关掉:把一部词典的 Strong's 深度设为零,这一切就都不适用了。食品标签上的添加剂、一份饮食里的成分、某个行业的术语、外派团队一遍遍要解释的行话,也都是一样。建一次,用很多年,需要的人随时拿去。
三者之一 —— 也能独当一面
三项服务生来就是彼此配合的,但没有哪一项离不开另外两项。它们之间的连接是设置,不是依赖:断开其中任何一项,你做出来的东西仍然是你的、仍然可读,也仍然能渲染。
经文引擎
Darash
希伯来文和希腊文、
词形分析、Strong's、
各部经典辞书
你引用一个词
作为词条返回
你的词典
Lexifye
chesed
ḥesed
你的词义、你的出处、
你有过的每一个版本
——还能把这一切付印
构建一部作品时
只取它用到的
写作
Junifye
一本书、一篇研读、
下周要发的讲义——
词汇表都已写好
经文引擎
Darash
希伯来文和希腊文、词形分析、
Strong's、各部经典辞书
你引用一个词
作为词条返回
你的词典
Lexifye
chesed
ḥesed
你的词义、你的出处、你有过的
每一个版本——还能把这一切付印
构建一部作品时
只取它用到的
写作
Junifye
一本书、一篇研读、下周要发的讲义
——词汇表都已经写好
两个箭头都是单向拉取。Lexifye 绝不写入 Darash,Junifye 的作品也绝不编辑你的词典。
在定义中引用H2617 ,Lexifye 就会去问 Darash 那是什么,然后把答案作为一个真正的词条写进你的词典:带元音点的希伯来文词目、SBL 转写,以及从各部辞书合成的词义——Strong's、Brown-Driver-Briggs、Abbott-Smith、Liddell-Scott-Jones、Thayer。走多远由你选择:只取你确实引用过的词、再往外一跳,或按需追得更深。它写下的任何内容都不能压过你——手写的词条在冲突时永远胜出。
把它关掉(深度设为 0),你的词典就完全不变;原文那部分你自己写就是了。
Lexifye —— 词语存放之处
就是本服务,也是三者中居中的一环,这是有意为之:它是整个生态里词汇内容的记录系统。定义只在这里撰写,别处都不写,下游的一切持有的是缓存而不是副本——所以这里的一个词一变,凡是引用它的内容按定义就是过期的,而且会被告知这一点。
它从不需要任何一位邻居:一部记录一位读者研读成果的私人辞典本身就是完整的,而且能印出来。
把一部作品指向一部词典,它的词汇表就会在每次渲染时自己生成:正文用到的术语,再加上你自己的定义 所依赖的术语,如此层层追溯,直到没有任何悬空为止。它会记录所取每条定义的确切版本,精确到校验和——所以你能证明在别人手里的那一版中,一个词当时是什么意思——而词条会保留发布时的锚点,无论你之后怎样改名。
什么都不指向,它就只是一个写作的地方。
一个词,走完全程
以下是实际发生的事,按发生顺序列出,每一步都用真实文本。这里没有一句是设想——这就是chesed 在本页顶部那份可下载示例中走过的路径。
你写下定义,并引用那个词
在编辑器里,用普通的散文,只给希伯来文加一个带标记的片段:
[h:H2617:ḥesed:חֶסֶד] denotes the *loyal, active love* that
binds parties in covenant — kindness that far exceeds
what mere obligation could require.
这就是你在这里需要用到的全部标记语法。往返是精确的:你读回来的内容,与以后每一次读取得到的完全一样。
Lexifye 向 Darash 询问 H2617 是什么
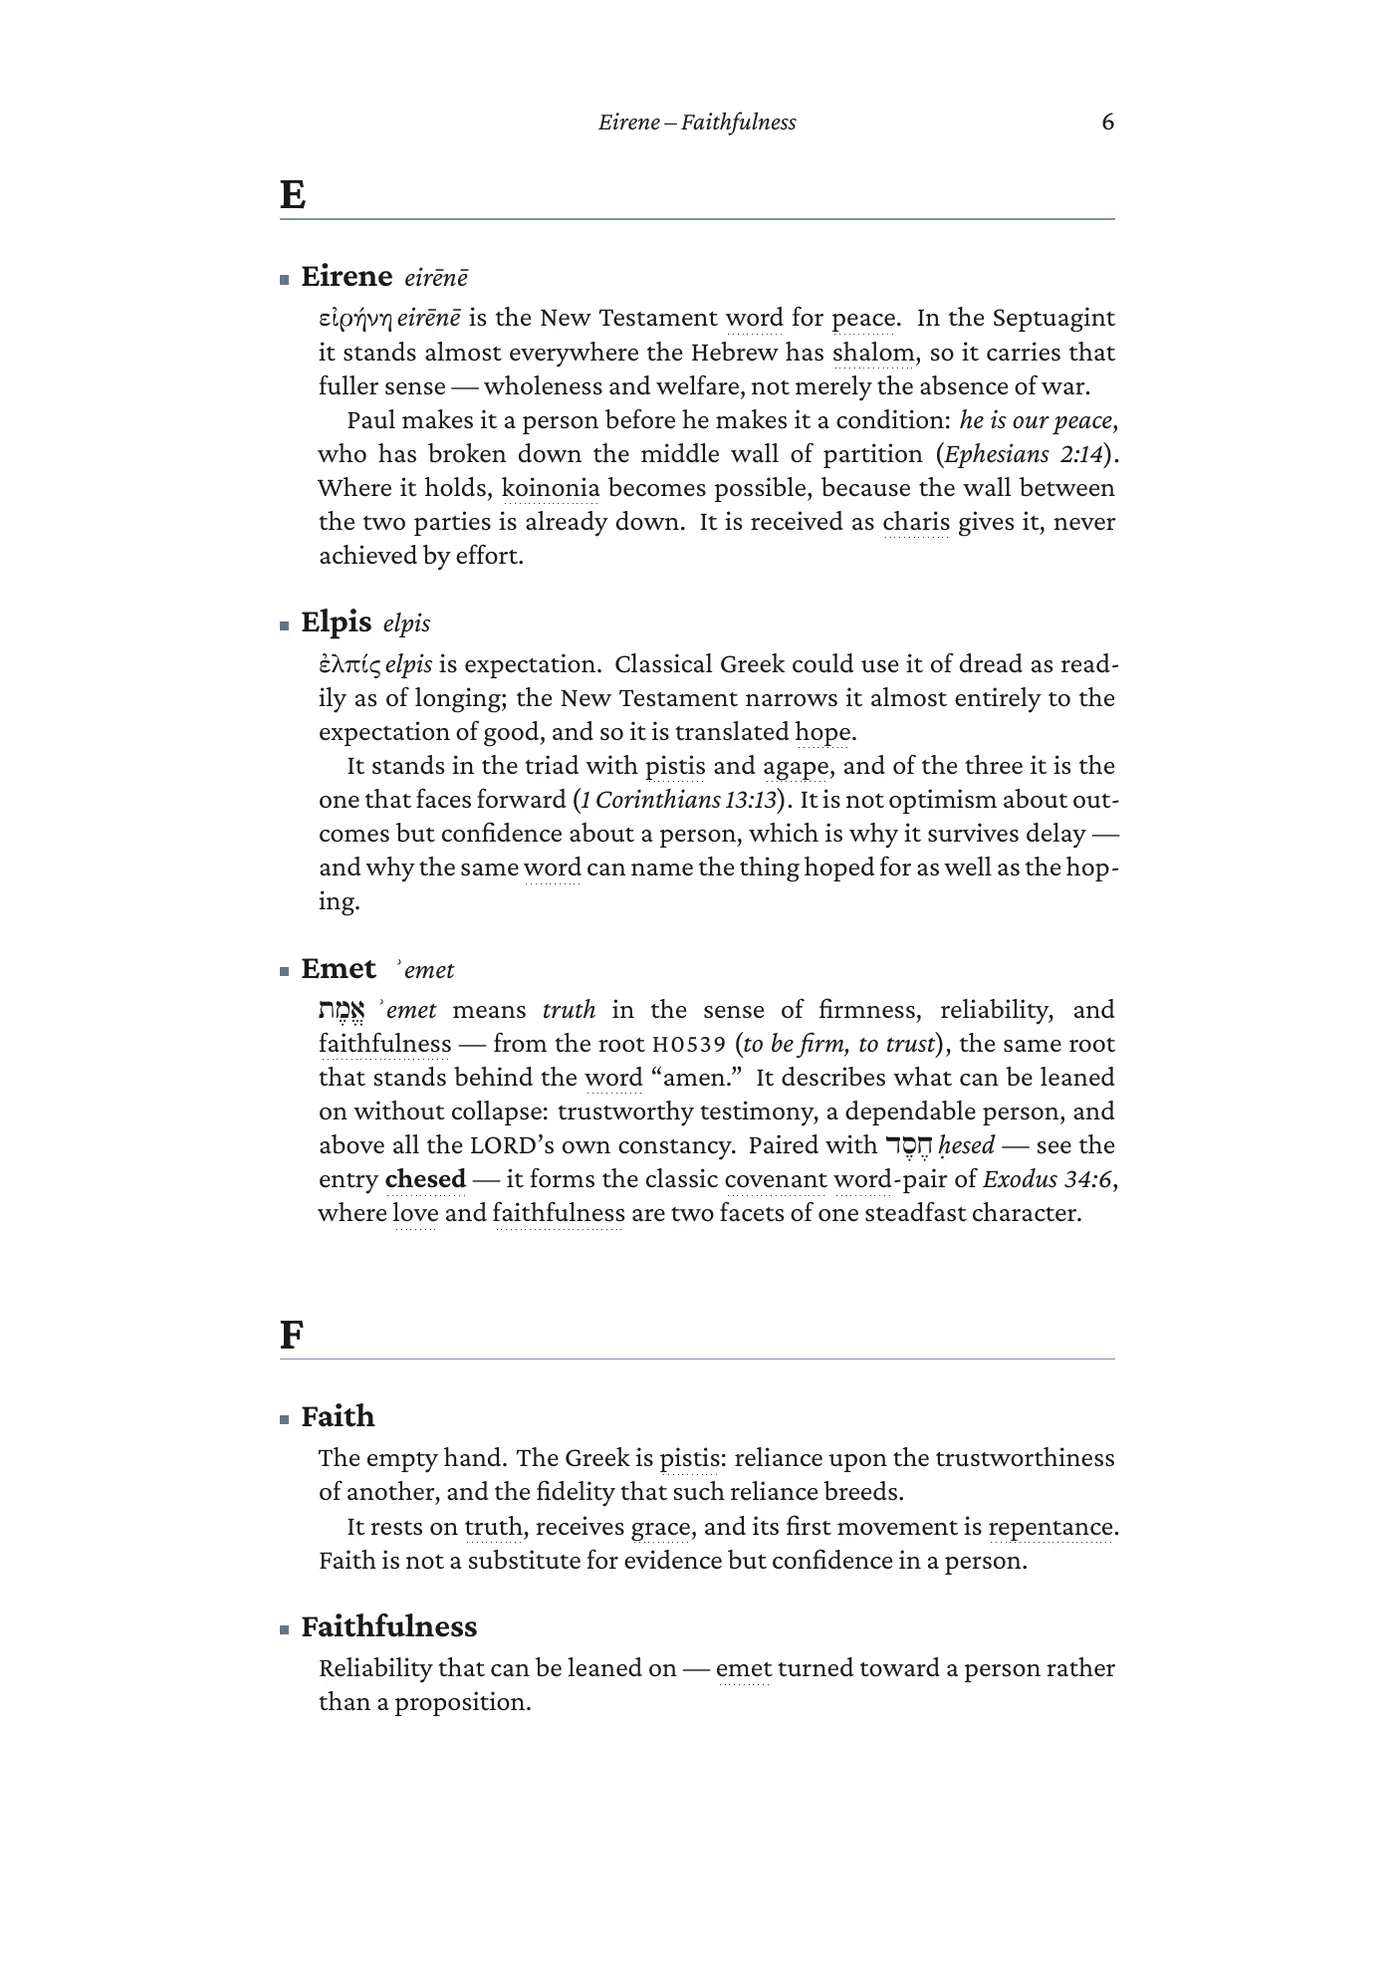
然后把答案作为一个真正的词条写进你的词典——带元音点的词目
חֶסֶד 、SBL 转写ḥesed ,以及由各部辞书合成的词义。它会被标记为机器生成、有数量上限,并且永远不能覆盖你亲手写下的词。
这一步走多远由你设定,从关闭到深度追溯都可以。不再引用某个词,它的自动词条就会被清理掉;你自己写的词条永远不受影响。
词典自己排好版
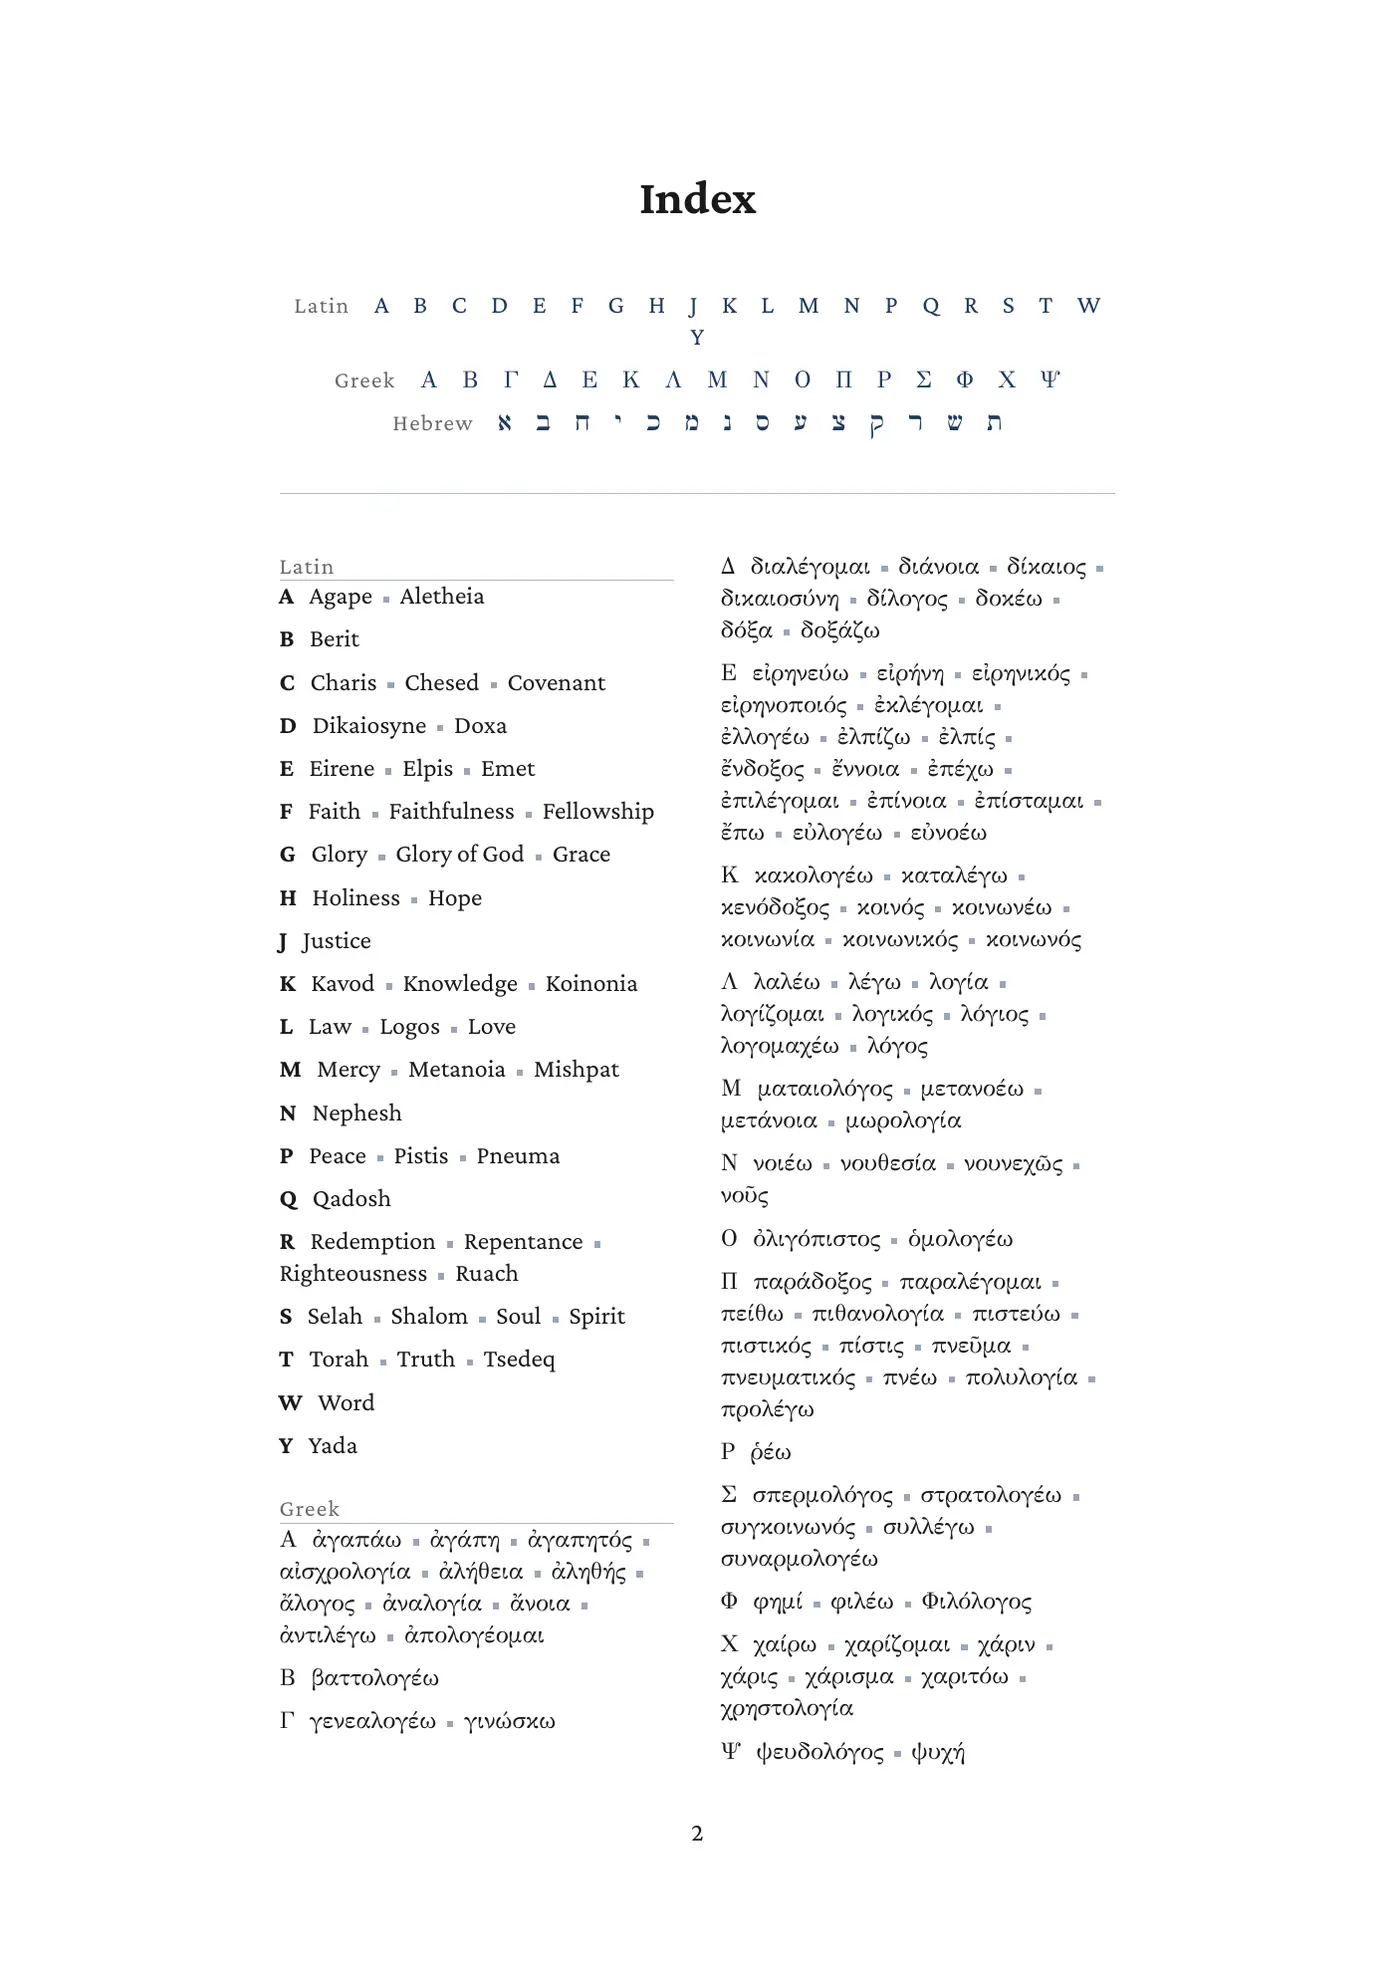
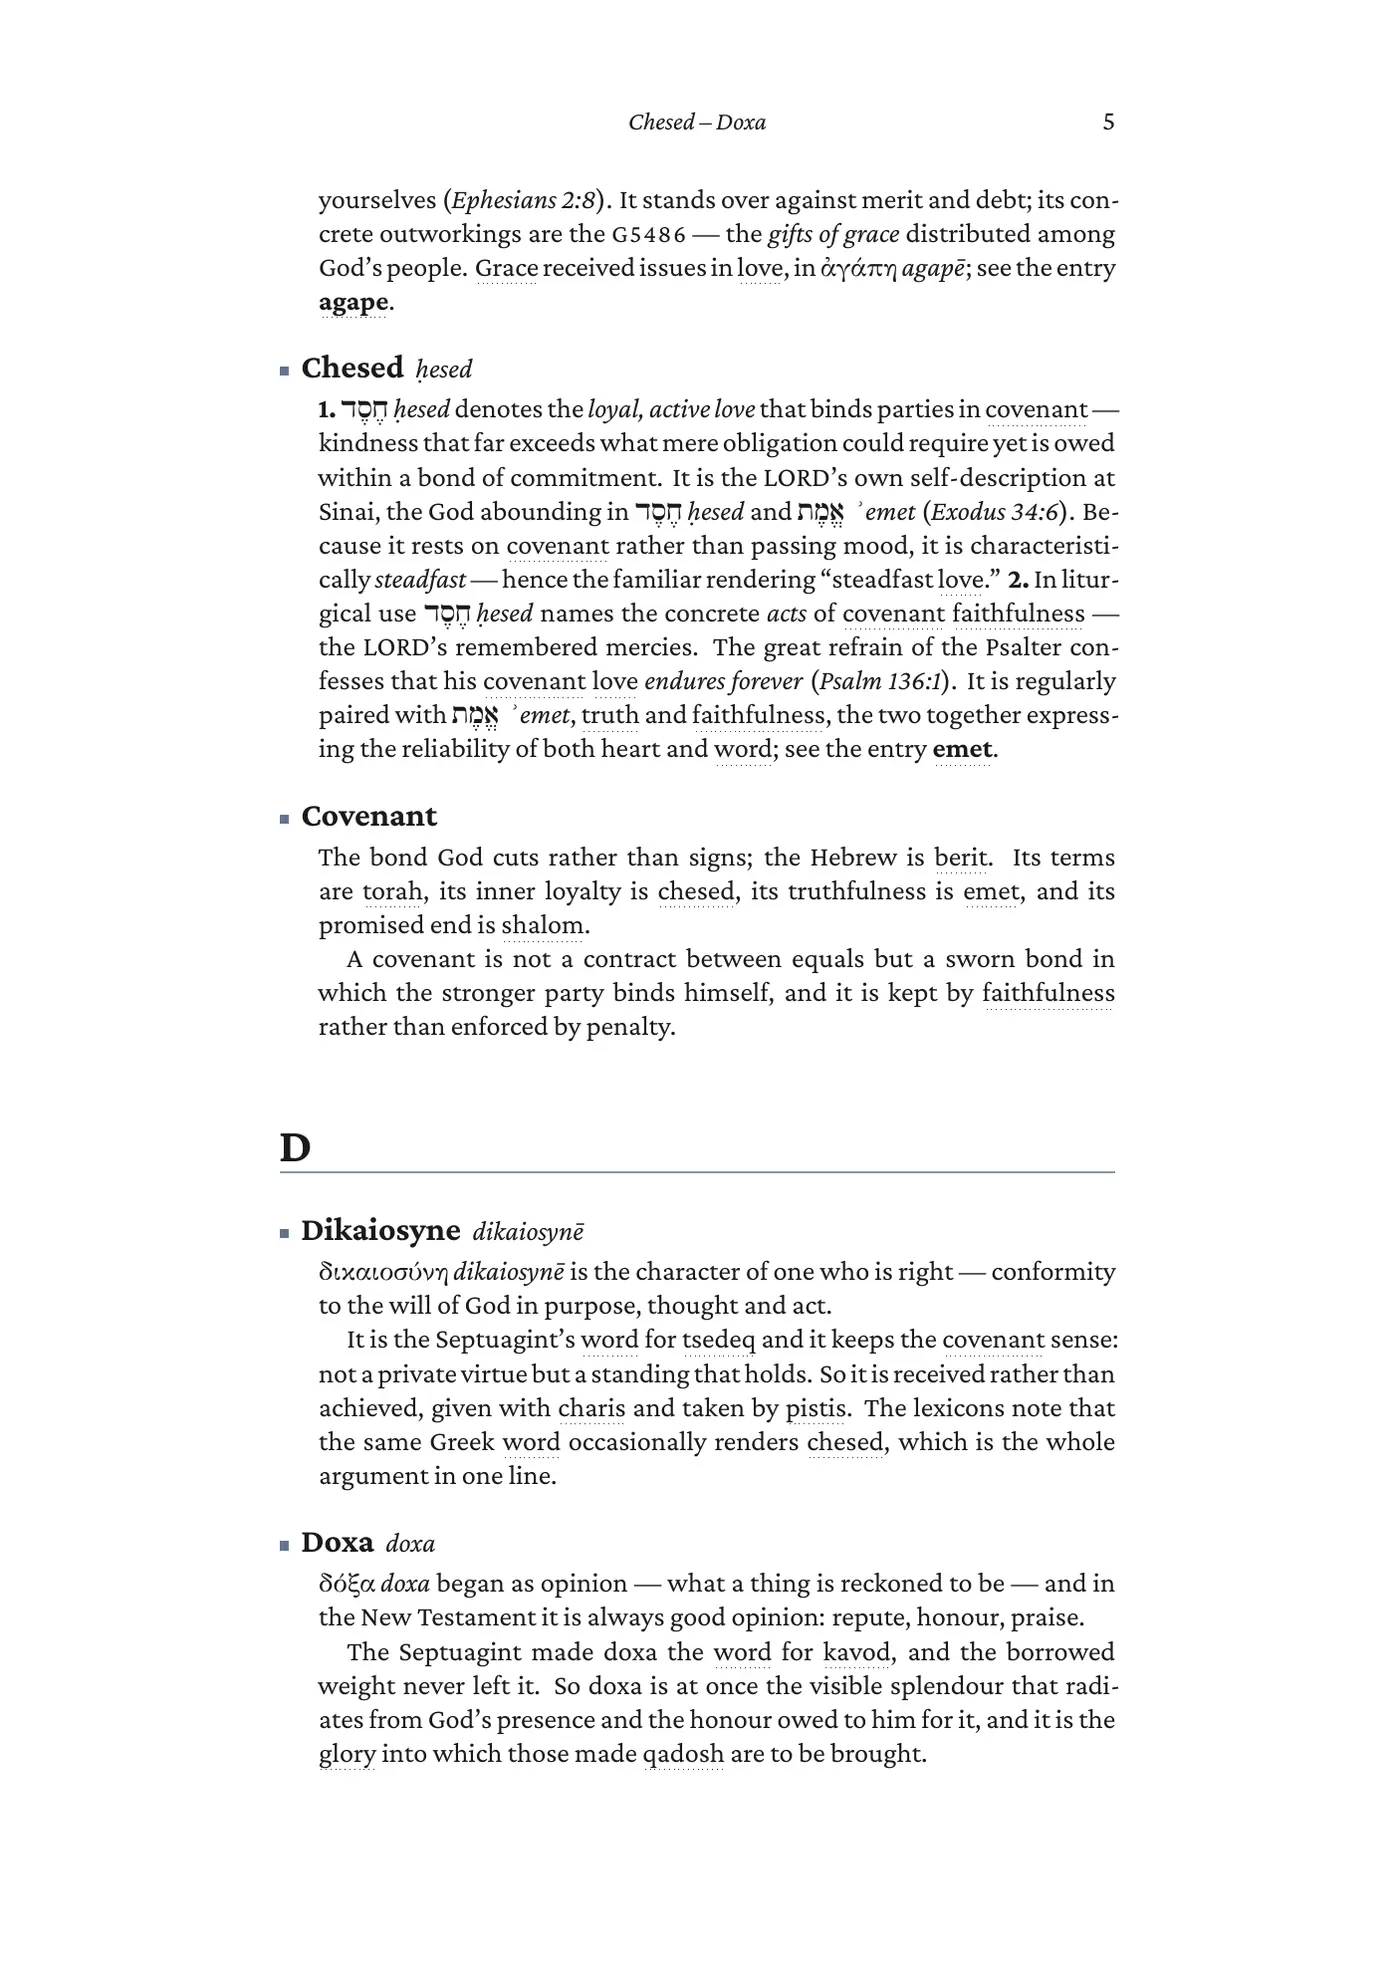
那条定义里每一次出现的圣约 都会变成指向“圣约”词条的链接,因为这部词典里正好有一条。词目印刷时首字母大写,存储时仍保持你输入的样子。它在字母索引中归入 C,书末的索引列出每一个词条,每一条既是可以去的地方,也是可以回来的路。
浅色或深色的屏幕版 PDF、带书眉导词的 6×9″ 内页、EPUB3、网页阅读器、JSON——或者原始 LaTeX,如果你想把它带到别处去。
Junifye 的作品只取它需要的
写一篇用到这个词的《路得记》研究,它的词汇表附录就会出现,里面有
chesed ——还有圣约 ,因为你对 chesed 的定义依赖于它,如此层层追溯,直到没有任何悬空为止。构建时会记录所用版本的确切校验和。
之后再修改词典,已经印出来的书也不受影响:词条会保留发布时的锚点。
词汇表到底做了什么
最后这一步是大家最常问的,所以这里讲全。把一部 Lexifye 词典连接到 Junifye 里的一部作品,词汇表就会自己写出来 。这不是“把术语导出再粘贴进去”——而是作品每次构建时,都会拉取它真正需要的词条。整本书如此,六页的文档同样如此:一卷圣经的研读、关于圣约或赎罪或敬畏耶和华的专题研究、一份讲义、一篇论文、一份系列讲道提纲。背后都是同一部词典。
它只取作品用到的部分。 正文中出现的术语,再加上——这一点常常出乎意料——你自己的定义 所依赖的术语。若你把
挽回祭 定义为hilastērion ,那么hilastērion 也会一并带上,如此层层追溯,直到没有任何悬空为止。它只链接每一章里的首次出现 ,句子的其余部分不动,因此正文读起来仍然像正文。在纸质版里,链接排成普通文字——那里的参考是附录,不会打断视线。它精确记录用了定义的哪一个版本 ,精确到校验和,所以你能证明在别人手里的那一版中,一个词当时是什么意思。修改词典永远不会弄坏已经印出来的书。 词条会保留发布时的锚点,无论你之后怎样改名或重排。你自己的措辞永远优先。 你写进书里的术语胜过导入的那一条;凡是你亲手写的,都不会被悄悄覆盖。
所以你写的第四份东西会比第一份更快,而不是更慢——因为那些词已经是你的了,已经定义好了,也已经排好版了。
一次一个词,积累数月
这不是一个坐下来就能做完的项目。它是这样一件事:某个星期二你被一个词拦住了,于是添了一条;三周后同一个词出现在你意想不到的地方,你又添了一条——而第二条比第一条更好,因为这一次你眼前有两处经文。
这正是关键,也正因如此,它必须是你自己的 。一整个冬天读下来的《罗马书》研究,一年来一直在打转的关于圣约的专题研究,某一卷福音书反复回到的那些词——这些都不是一次坐下来能装得下的。它们是累积起来的。半年之后,你不再只是在查东西;你是在读经的时候,把自己的成果摊在经文旁边一起读。
至于还有谁能看到它,你可以稍后另行决定:把它保持私密
,那它就是一位读者个人研读的辞典;分享给一个群组 ——你的班级、你的长老们、一支外派团队——大家便按同一套义项工作;把它出版
成一本书、一个 EPUB 或一个阅读器,它就能送到你想给的任何人手里。这个决定不必在一开始就作出,也随时可以更改。
不必只有你一个人
词典是那种少见的工作:多一个人参与就会更好——但如果那个人只能收到一个文件、然后在页边写批注,就会更糟。所以我们提供了两种截然不同的方式让别人进来,而分清你需要哪一种,事情就成了大半。
一个人,一部词典
受邀编辑只被加入某一部词典,别的都碰不到。你的导师、研究同一批语料的同事、比你早读一章的同学、那位真正读得懂希伯来文的弟兄。他们在工作真正发生的工具里拿到词条、历史记录和阅读器——所以他们发现错误时是直接改掉,而不是描述一番。收回权限,他们下一次点击时就没有了。
一个常设群组
你的长老们、一个研讨班、一支研究团队、一个翻译委员会、一个理事会。把群组挂上去,每位成员都是那部词典的编辑者;把某人加进群组,他就有了。打开自动共享,群组还会自动获得你新建的每一部词典,你便不用再一部一部地授权。
或者一群只需阅读的读者
一个班级、一间教会、一批学生。他们从你这里只需要文件本身:EPUB、在手机上就能用的阅读器,或者人手一本纸质书。不用登录,不用安装,不用账号,人数也没有上限。
谁做的事都不会无法挽回。每一次改动都会在那部词典自己的日志里记下改动者的姓名,每条定义保留二十个版本并可查看差异、可回退,删掉的词条会在回收站里存放三十天。你可以把真正的权限交给别人,而不必同时把毁掉一年心血的能力也交出去——而后者才是真正让人不敢协作的原因。
这一切都不额外收费。你的套餐计的是词典数量,不是人数。
与人工智能一同在里面工作,而不是各干各的
大多数人让助手帮忙做研究时,都是开着另一个窗口,把内容来回粘贴,半路上丢掉一半。Lexifye 的思路正相反:智能体能够访问的那部词典,就是你正在看的那一部。
把智能体指向它,它就能搜索你的词条、查找某个词目、用你手写时所用的同一套标记起草义项,并一次性修正四百条定义里的某个术语——而且在动手之前,会把要改的内容原原本本先给你看。它以你的身份登录,因此你能做什么它才能做什么,绝不多一分:你的词典、你的权限,不需要第二个账号。
而且差异记录始终在你手上。智能体所做的每一次修改都像你自己的修改一样有版本、可回退,并与其他记录一同出现在日志里。你不是在信任它——你是在事后按自己的节奏审阅它。
一本可以上书架的书
把同一部词典渲染成带书眉导词的 6×9″ 印刷内页,然后装订成册。从纸上研读、在上面划记、放在椅子旁边——对于那种要花上多年的阅读,这一直是行得通的形式。
一次讲话背后的笔记
一篇讲道或一堂课所系于的那五个词,在你站上去之前就好好定义清楚。你不必讲到一半再去查;你早已定下来,而且说得出理由。
一个班级或一间教会在读它
把 EPUB、阅读器,或者人手一本印刷版交给他们。这对他们没有任何要求,对你也只需要那个文件——在公交车上用手机就能读,不用注册账号,你想发给多少人都可以。
几个人和你一起写它
这完全是另一回事。一位合著者、一位导师、两位研究同一批语料的同事、你们的长老们。把他们加为受邀编辑,或者挂上他们本就在其中的群组,你们就都在同一部词典里了——每一次改动都带着名字,每条定义都可回退。
一个常设的院系或团契
一个群组,挂上一次,就会自动接管你新建的每一部词典。你不用再一部一部地授权,新加入群组的人第一天就拥有全部内容。
你自己的长期研读
别人永远不必看到它。一部只写某一卷圣经、或只写那些一再拦住你的词的私人辞典,本身就是完整而值得的。
在你另作决定之前,一切私密
这里没有公开词典。 没有凭证,这里的任何东西都无法浏览、无法被搜索引擎收录、也无法取回——阅读器不行,JSON 不行,PDF 也不行。知道某个 id 或 UUID 并不等于有权访问。你写下的东西一直属于你,直到你亲手交给别人。
而当你要交出去时,有两种截然不同的做法。把人请进来——某一部词典上的受邀编辑,或者一个常设群组,比如长老会、班级委员会或外派团队——他们与你一同在里面工作,每一次改动都带着他们的名字。或者把一份副本交给读者:EPUB、阅读器或印刷内页,这对他们没有任何要求,人数也没有上限。同样,没有什么是真正被删掉的:软删除带三十天宽限期,每一类实体都能还原,每条定义保留二十个版本,可查看差异并回退。
有三类调用方可以取得内容:通过 Publifye SSO 登录的作者;持有我方授权服务器所发 OAuth 令牌的客户;以及获得授权、以服务对服务方式调用的 Publifye 服务——后者只能读取 ,绝不能写入。本页面、工具接口,
/llms.txt 以及 /health 是仅有的匿名可取内容。
以后你才会发现的东西
先找到它,再到处改好它
你可以按词目的任意一部分搜索词典,也可以按定义里实际写了什么来搜——你不必记得三月里写下的那个词究竟怎么拼。而当你改变主意、想换一种译法时,一次字面查找替换会一口气跑遍每一条定义,写入之前先给你预览。它绝不碰 Strong's 编号、引用或链接目标,只动正文。它所做的每一处改动都可回退。
怎么排是你说了算
A4、Letter 或 6×9″。正文字号以排版引擎真能做到的为准——做不到的尺寸它会拒绝,而不是假装做到。词条可以连排,长条目的词典也可以一条一页。链接可开可关,可选每一次出现都链接,或只链接词条中的首次出现。这些属于词典,不属于我们:这里没有哪一项设置是渲染器背着你替你决定的。
永远不会离开你书桌的笔记
针对整部词典或某一个词条的私人笔记——你否决掉的读法、还需要核对的经文、想请教别人的问题。编辑者可见,绝不会被渲染进任何格式,也绝不导出;词条进回收站时它跟着进去,还原时也跟着回来。它们是工作笔记,不是内容。
内部构造
Lexifye 同时也是 Publifye 生态中词汇内容的记录系统:定义只在这里撰写,别处都不写,其他服务持有的是缓存 ——绝不是真相的副本。这里的一个词一变,下游的一切按定义就是过期的,而且会被告知这一点。
词典 → 词条 → 定义
一部词典包含词目;一个词目包含一个或多个义项。义项是结构化内容——由带类型的片段组成的区块——而不是一团散文,正因如此,同一条定义才能正确地排成 PDF、EPUB 和网页。
94 个原子化 MCP 工具
每一次写操作都是一次小而经过校验、单独授权的调用。错误信息是写给需要从中恢复的智能体看的:每条都指明字段、修法,以及一个最小的有效调用。
可无损往返的标记
定义有一种紧凑的文本形式,并保证
parse(render(x)) == x ——往返一致性针对的是解析后的文档,而不是你输入的字节。一次规范化处理可能会整理文本本身(\# → #,
[H00002617] → [H2617]);此后它便是一个不动点,你读回来的内容,与以后每一次读取得到的完全一样。
出版级渲染
浅色与深色的屏幕版 PDF、带书眉导词的 6×9″ 印刷内页、EPUB3、HTML 阅读器、JSON,以及原始 LaTeX——覆盖 16 种文字系统,并有字形关卡把关:宁可让渲染大声失败,也绝不输出乱码方块。
Strong's 编号增补
定义中引用的原文词会变成真正的词条——原文词目、SBL 转写、合成词义——由我们的经文引擎提供,并在你编辑时随时校准。手写的词条在冲突时永远胜出。
并发锁与历史
每一次内容修改都带着它所基于版本的凭证,因此同时编辑的人不会悄悄覆盖彼此。每条定义保留二十个版本、存放七天,可查看差异并回退。
群组与受邀编辑
既可以把一个人以受邀编辑的身份加进某一部词典,也可以挂上一个常设群组,让每位成员都成为它的编辑者。群组可以自动接管你新建的每一部词典,词典也可以直接移交给已经在其中工作的人。成员身份在校验时才判定,因此撤销是即时的,而不是慢慢生效。
没有什么是真正被删掉的
删除默认是软删除,有三十天的宽限期,每一类实体都能还原;每一次改动都会在按词典划分的审计流里记下责任人。
三层持久化
Redis 承载工作集,内容寻址的二进制块和按词典划分的导出文件落在磁盘上,其后还有一个只增不删的对象存储镜像。恢复流程是每次提交都会跑的测试,而不是一份文档。